iPhone版
 Android版
©️镜象娱乐
文丨桨声
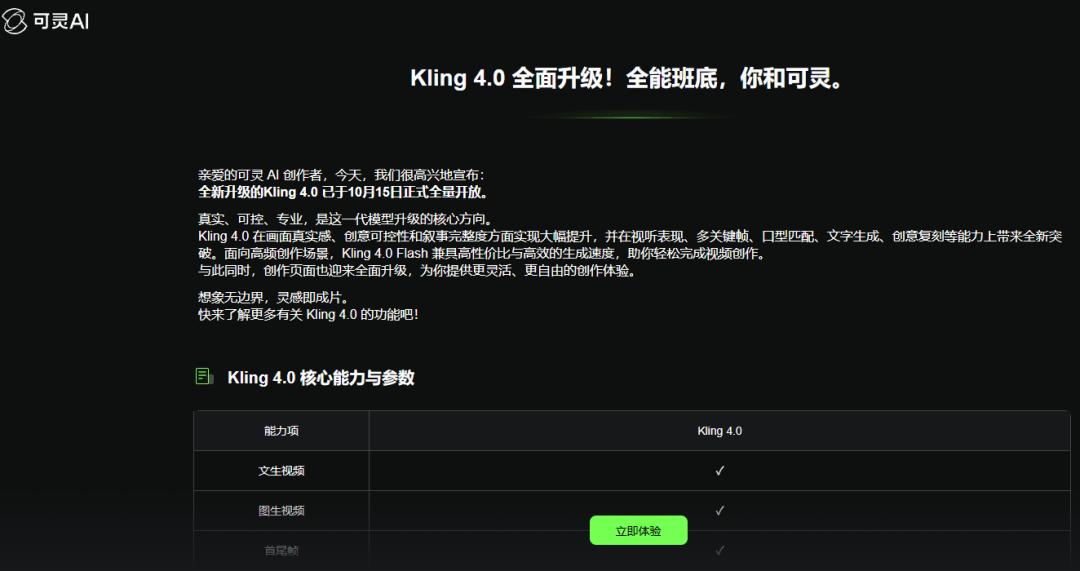
10月中旬,快手旗下可灵AI新一代视频生成模型Kling 4.0正式上线。
根据可灵官方介绍,Kling 4.0支持单次生成最长30秒的视频,最多使用10张关键帧引导画面变化,并支持单次任务组合使用最多15项多模态参考素材。人物动作、镜头运动、场景切换与视频编辑,也被纳入更完整的创作流程。
这意味着,AI视频生成的竞争,从画面够不够逼真,转向能否精准执行创作者的意图,包括人物如何运动、镜头何时切换、产品出现在哪里,都要可控。
过去几年,AI视频的进步有目共睹。从最初的画面闪烁、人物变形,到如今可以生成具有电影质感的连续画面,技术能力不断向前推进。但在实际创作中,画面质量只是起点。人物能否保持一致,动作是否符合物理规律,镜头之间能否形成连贯叙事,往往更能决定一段视频是否真正可用。
Kling 4.0的升级,是对这些痛点的回应吗?
笔者将从人物动作、连续叙事和创作可控性等维度展开实测,看看新模型究竟把AI视频创作推进到了哪一步。
从“画面好看”到“动作成立”
AI视频在补哪块短板?
对于AI视频生成而言,静态画面的质感与动态过程的合理性,是两种不同的考验。
一张人物肖像,可以通过光影、皮肤纹理、服装细节营造出逼真的视觉效果。但当人物开始奔跑、转身、跳跃,甚至与其他人物发生肢体接触时,模型需要同时处理身体结构、运动轨迹、空间关系以及外部环境的反馈。
这也是为什么,一些AI视频单帧看起来相当惊艳,连续播放却可能出现人物滑步、肢体错位、物体突然消失等问题。
可灵此次将动态运动与物理交互列为升级重点。官方介绍称,Kling 4.0针对快速动作、复杂人物互动和电影化运镜进行了优化,试图提高人物动作的稳定性与连续性。
但参数和官方演示并不能完全替代实际测试。对于创作者来说,模型在复杂场景中能否维持动作逻辑很重要。
实测一:武打动作与环境交互
笔者首次测试聚焦文生视频,使用 Kling 4.0 生成一段15秒的写实武打短片,重点考察其对连续动作顺序的执行能力。
提示词如下:
“中国古代客栈内,两名身着不同颜色劲装的武者隔桌对峙。镜头从两人面部特写缓慢拉开,一人突然侧身闪避,另一人挥拳击中木桌边缘,桌上茶杯震动落地。双方连续完成格挡、转身、扫腿与后撤动作,桌椅受到碰撞发生位移,周围食客惊慌避让。最后两人拉开距离,重新摆出对峙姿态。真人电影质感,动作符合人体力学,人物服装和面部保持一致,镜头运动连贯,环境光自然。”
生成效果如下:
笔者发现人物动作基本按照既定顺序完成,无动作突然中断情况;人物尚未明显出现失去重心或肢体错位;桌椅、茶杯等物体受到碰撞后,产生了较为合理的运动反馈;镜头切换或移动后,人物面部、发型和服装基本保持一致。
但提示词中的“隔桌对峙”未得到准确呈现。两名主人公均位于桌前,笔者推测,这样的站位可能减少人物与桌子的动作干扰,使后续动作更容易执行。
面对复杂的空间关系,模型似乎选择了更简单的呈现方式:两名主人公都站在桌前,绕开了真正的“隔桌对峙”。仅凭生成结果,可以判断模型没有准确执行指令,但不能确定它是主动规避难题,还是空间理解与生成能力存在局限。
另外,提示词要求“另一人挥拳击中木桌边缘,桌上茶杯震动落地”,但生成画面中,挥拳动作并非发生在双方对峙的动作博弈中,而更像是直接冲着茶杯击打,未能准确还原预设的动作逻辑。
此外,茶杯第一次破碎后又复原,未能维持前后镜头中的物理状态一致性。这反映出模型对提示词中动作先后顺序及因果关系的理解不充分,对复杂指令的准确执行还有提升空间,也说明提示词的组织方式和表达清晰度可能影响生成效果。
如果说动作场景考验的是模型对运动规律的理解,那么人物情绪则是另一道难题。
AI生成的人物,过去常常能做到形似,却不一定能够传递情绪。一个眼神、一瞬间的迟疑,或者从紧张到释然的表情变化,都需要模型在连续画面中维持细微而自然的过渡。
这类能力看似不如复杂打斗显眼,却与影视短片、广告和剧情内容的实际需求密切相关。
实测二:人物表演与微表情
笔者此次的测试方向,是一个人物在单一场景中的情绪变化完成度,重点检验面部稳定性和镜头调度。
提示词如下:
“一位三十岁左右的亚洲女性独自坐在雨夜的咖啡馆窗边,桌上放着一封尚未拆开的信。镜头从窗外雨滴的近景缓慢推进到人物侧脸,她低头看着信封,手指轻轻摩挲边缘,短暂停顿后拆开信件。阅读过程中,她的表情从克制、疑惑逐渐转为悲伤,最后露出一个略带释然的微笑。窗外车灯在玻璃上形成柔和反光,人物动作自然细腻,面部结构稳定,写实电影摄影,浅景深,情绪表达克制。”
生成效果如下:
笔者发现,人物面部基本在特写与中景之间保持稳定,手部动作自然,情绪变化基本连贯;镜头推进过程中,光线和人物位置没有发生不合理变化。
不过,模型对人物情绪递进的呈现仍不够细腻。
提示词要求人物从克制、疑惑逐渐转向悲伤,最终露出略带释然的微笑,但生成结果中的情绪转换略显生硬,面部表情存在一定的迟滞感,尤其是结尾的微笑出现得较为突兀。
相比真人专业演员通过细微的面部变化、眼神和表情节奏传递复杂情绪,这位AI演员尚未建立起足够连贯、可信的情感表达逻辑,难以让观众感受到情绪转变的内在动因。
30秒、10个关键帧
从生成一段视频,到组织一段叙事
过去, AI视频生成常需将复杂叙事拆成多个短片段,再通过剪辑拼接。这虽能突破时长限制,却容易导致人物形象不一致、场景衔接跳跃、动作前后脱节等问题。
Kling 4.0将单次原生生成时长提升至30秒,并支持最多10张关键帧。创作者可通过关键帧设定人物姿态、场景变化、镜头构图等视觉节点,再由模型生成其间的动态过程。
两项能力结合,改变的不只是视频时长。更长的时限为情节推进留出空间,关键帧则增强了画面控制力,让人物出场、产品亮相和镜头转换更可控。
然而,时长增加并不等于叙事能力提升。视频越长,人物和场景维持一致性的难度也在加大。
实测三:连续叙事与空间逻辑
此次的测试方向,是一段从街头追逐到室内穿行、最后完成动作收尾的连续短片。
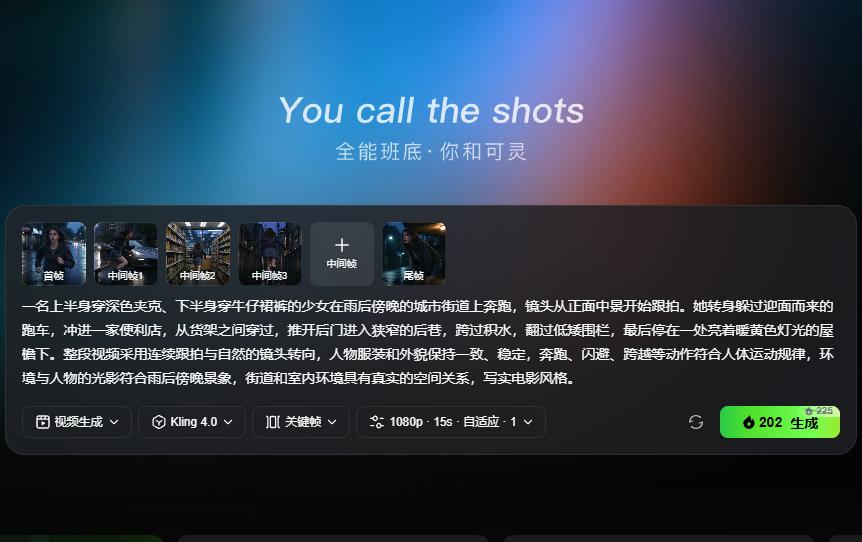
笔者上传5张分属不同时间节点的场景画面:少女起跑(首帧)、躲避跑车(中间帧1)、穿过便利店(中间帧2)、跨过积水(中间帧3)、最终停下(尾帧)。尝试用关键帧控制重要节点,观察模型能否在指定节点附近完成动作与构图过渡。
提示词如下:
“一名上半身穿深色夹克、下半身穿牛仔裙裤的少女在雨后傍晚的城市街道上奔跑,镜头从正面中景开始跟拍。她转身躲过迎面而来的跑车,冲进一家便利店,从货架之间穿过,推开后门进入狭窄的后巷,跨过积水,翻过低矮围栏,最后停在一处亮着暖黄色灯光的屋檐下。整段视频采用连续跟拍与自然的镜头转向,人物服装和外貌保持一致、稳定,奔跑、闪避、跨越等动作符合人体运动规律,环境与人物的光影符合雨后傍晚景象,街道和室内环境具有真实的空间关系,写实电影风格。”
生成效果如下:
视频整体呈现出较强的电影化视觉风格,画面质感与镜头表现具有一定的大片感。
一个较为突出的优点是,生成的少女面部清秀自然,避免了常见AI人像中趋于同质化、模式化的“标准美女脸”。同时,画面保留了适度的黑眼圈和细微皮肤纹理,弱化了过度磨皮带来的塑料感,增强了人物面部的真实感与自然质感。
笔者将成片拆成三个观察阶段:街头奔跑、室内穿行、后巷收尾。整体来看,人物运动轨迹较为连贯,动作链完整;人物在不同空间场景中保持了较好的一致性,结尾也能自然收束。
但在场景转换与动作逻辑方面,仍存在一定不足。从室内穿行转入后巷时,少女直接破玻璃而出,未能结合既定场景环境合理调整运动路线。这表明,模型虽然能够延续人物的运动状态,但对空间环境的理解与场景约束的运用仍有提升空间。
在提示词执行方面,视频基本保留了关键动作,未出现明显遗漏,但个别动作的执行偏离了预期,例如少女跨越水沟时,额外出现了越墙动作,使动作路径显得冗余,反映出模型对具体动作指令的执行精度仍有不足。
另一值得注意的细节是,提示词设定为“牛仔裙裤”,生成画面涉及跑跳动作,模型在视觉呈现上却更倾向于将少女的下装处理为紧身牛仔短裙,未能充分体现“裙裤”的服装特征,也未突出其兼具裙装外观与裤装便利性的特点。
除了关键帧,Kling 4.0还支持全能参考,可在单次生成任务中组合使用多种参考素材。根据官方资料,单次任务最多支持15项参考素材,其中包括最多10张图片、5段参考视频和7个主体;此外,还支持音色参考。
这意味着创作者不必完全从零开始描述画面。人物形象、场景氛围、动作参考与声音参考等素材,可以在支持的工作流中辅助生成过程。
对于广告创作,这种能力尤其值得关注。
实测四:产品展示与参考素材
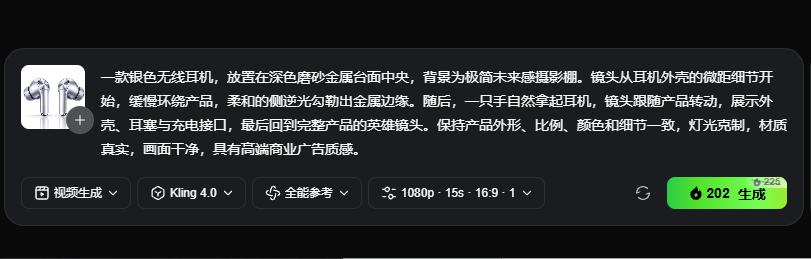
此次笔者测试的方向,是使用产品参考图(该产品图由AI生成)生成一条电子产品广告。
提示词如下:
“一款银色无线耳机,放置在深色磨砂金属台面中央,背景为极简未来感摄影棚。镜头从耳机外壳的微距细节开始,缓慢环绕产品,柔和的侧逆光勾勒出金属边缘。随后,一只手自然拿起耳机,镜头跟随产品转动,展示外壳、耳塞与充电接口,最后回到完整产品的英雄镜头。保持产品外形、比例、颜色和细节一致,灯光克制,材质真实,画面干净,具有高端商业广告质感。”
生成效果如下:
整体来看,产品的轮廓、细节、色彩及比例均保持了较好的一致性,镜头运动也能突出产品主体,强化视觉焦点。在手部与产品发生接触时,产品形态依然稳定,体现出模型对产品外观一致性的较好控制。
惊喜的是,模型还自动生成了广告词的画外音,能够理解并呈现广告表达意图。不过,在配音的语气与节奏上,自然度仍有提升空间。
技术迭代之外
AI视频要走向怎样的生产力?
评价一个视频生成模型,最终不能只看几段演示视频。
对普通创作者来说,模型能否降低制作门槛、缩短试错时间,决定了它是否值得长期使用;对企业客户而言,生成质量、可控性、修改成本与工作流兼容性,则共同影响实际投入产出。
从这一角度看,可灵4.0的升级方向,已经不局限于单纯提升视觉效果,而是在向更完整的创作工具链延伸。
2026年8月19日,快手发布的第二季度及上半年业绩公告显示,可灵AI第二季度营业收入超过8.5亿元人民币,同比增长超过200%;同期,快手整体第二季度营收为355.35亿元人民币,同比增长1.4%。快手将可灵AI业务增长主要归因于模型能力提升、产品功能完善及应用场景拓展。需要注意的是,上述数据反映的是业务收入及其增长情况,并不直接代表可灵AI的盈利水平或市场份额。
这组数据至少说明,AI视频生成已经不只是面向个人用户的创作尝鲜工具,也在形成可被单独观察的商业业务。
但收入增长只是其中一面。视频生成模型需要持续投入研发和算力,企业客户对稳定性、版权、数据安全和服务能力也有更高要求。随着产品进入广告、短剧、影视预演等专业场景,用户衡量模型的标准势必从“能不能生成”转向“能不能稳定交付”。
同样,行业竞争也不再只是比较谁能生成更长的视频。
以字节跳动的 Seedance 2.5 为例,该模型同样支持单次生成最长30秒的视频,并提供多模态参考与精准视频编辑能力。两者在关键帧控制、参考素材类型及数量、编辑功能和服务接入方式等方面各有不同。因此,不能仅凭功能参数判断模型的整体表现,仍需结合具体任务、生成设置与实际测试结果综合评估。
不过,模型能力提升,并不意味着专业制作流程会被完全取代。复杂作品仍然需要脚本、分镜、素材管理、剪辑、声音设计和质量审核。对于有明确商业要求的项目,产品外观、人物细节、画面文字与动作逻辑,也依然需要逐项检查。
镜象娱乐
镜象娱乐官方正观号